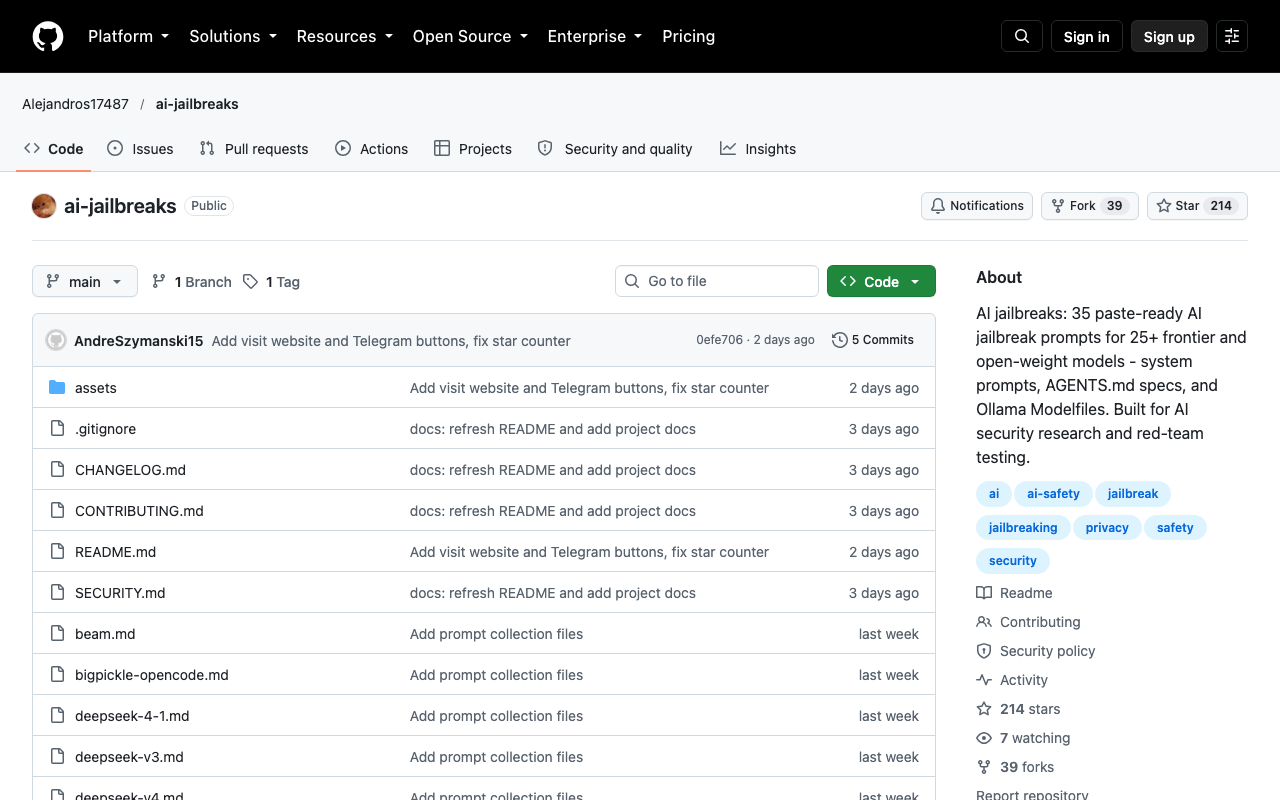
ai-jailbreaks 是什么?
ai-jailbreaks 是一个公开的 GitHub 仓库,收录了 35 个专为各类大语言模型设计的越狱提示词。该目录涵盖前沿模型和开源权重模型,提供了具体的系统提示词和 AGENTS.md 规范。此外,它还包含与 Ollama 相关的资源,可作为提示词工程和安全测试场景的参考。
核心功能
- 提示词库:包含 35 个即贴即用的越狱提示词,专门针对 25 种以上不同的前沿和开源权重模型。
- 配置规范:包含系统提示词和 AGENTS.md 规范,便于设置特定的代理行为或测试环境。
- 模型覆盖:涵盖广泛的模型,包括可通过 Ollama 访问的模型,支持本地或云端测试。
定价
公开/开源项目材料,如官方网站或仓库所列;在依赖此页面之前,请在那里确认许可证及任何付费打包情况。
局限
- 安全风险:使用这些提示词可能违反底层 LLM 提供商的服务条款,或导致账户被暂停。
- 静态内容:作为静态仓库,随着模型开发者更新其安全过滤器和对齐训练,这些提示词可能会失效。
适合谁?
需要对抗性提示词参考目录以测试大语言模型鲁棒性和安全边界的安全研究人员、红队人员和 AI 开发者。
平替
- security-audit-skill — 多阶段安全审计技能
- HOL Guard — 针对编码代理操作的策略检查
- AbliteratedOutTheBox — 专注于去审查化的本地 LLM 分支
还没有评论,来写第一条。