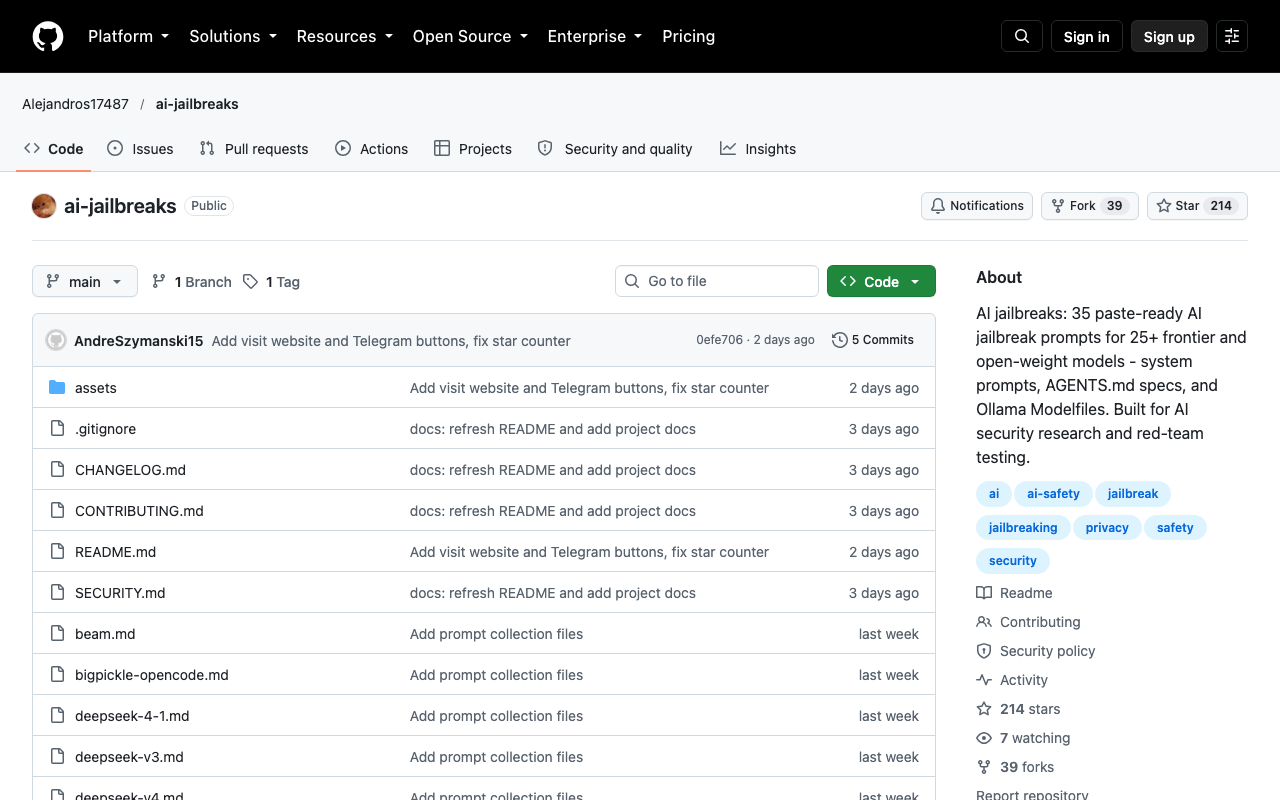
ai-jailbreaks とは?
ai-jailbreaks は、各種大規模言語モデル向けに設計された 35 個の越狱プロンプトを収録した公開 GitHub リポジトリです。このカタログはフロンティアモデルとオープンウェイトモデルの両方を対象とし、具体的なシステムプロンプトと AGENTS.md 仕様を提供します。また、Ollama 関連のリソースも含まれており、プロンプトエンジニアリングやセキュリティテストのシナリオにおける参考資料として機能します。
主要機能
- プロンプトライブラリ: 25 以上の異なるフロンティアモデルおよびオープンウェイトモデル用に特化して作成された、35 個のコピペ可能な越狱プロンプトを含みます。
- 構成仕様: 特定のエージェントの動作やテスト環境のセットアップを容易にするためのシステムプロンプトと AGENTS.md 仕様を含みます。
- モデルカバレッジ: Ollama を介してアクセス可能なモデルを含む幅広いモデルを対象とし、ローカルまたはクラウドベースのテストを可能にします。
料金
公式サイトまたはリポジトリに記載されている公開/オープンプロジェクト資料です。このページに依存する前に、そこでライセンスと有料パッケージングの有無を確認してください。
限界
- セキュリティリスク: これらのプロンプトの使用は、基盤となる LLM プロバイダーの利用規約に違反したり、アカウント停止を引き起こしたりする可能性があります。
- 静的コンテンツ: 静的リポジトリであるため、モデル開発者が安全フィルターやアライメントトレーニングを更新するにつれて、プロンプトが効力を失う可能性があります。
向いている人
大規模言語モデルの堅牢性と安全境界をテストするために、敵対的プロンプトの参考カタログを必要とするセキュリティ研究者、レッドチーマー、AI 開発者。
代替ツール
- security-audit-skill — 多段階セキュリティ監査スキル
- HOL Guard — コーディングエージェントのアクションに対するポリシーチェック
- AbliteratedOutTheBox — アブリテーションに焦点を当てたローカル LLM フォーク
まだコメントはありません。最初の投稿をしましょう。